Привет, Хабр! Меня зовут Михей, я разработчик. Когда сервис начинает тормозить, первая мысль у многих звучит так: база не вывозит, пора шардировать. Между «тормозит» и «шардируем» обычно лежит шесть шагов, которые стоят заметно дешевле. Покажу, в каком порядке я по ним иду.
По дороге разберём историю про счётчик голосов, которую мне рассказали на одном собеседовании. Я воспроизвёл её на стенде и получил цифры, а не впечатления. Примеры на PostgreSQL 16, все замеры мои, условия и оговорки описаны рядом с результатами.
Три разных «медленно»
Фраза «база тормозит» прячет три разные ситуации, и лечатся они по-разному.
- Один тяжёлый запрос. Он читает всю таблицу, сортирует на диске или тянет лишнее. Лечится индексом или переписыванием.
- Много быстрых запросов. Каждый быстрый, но их тысячи в секунду. Классика: N+1, когда на каждую строку списка уходит отдельный запрос. Лечится сокращением числа запросов, кэшем, пулом соединений.
- Ожидание. Запросы короткие, но стоят в очереди за блокировкой, а процессор базы почти свободен. Лечится изменением способа обновления данных.
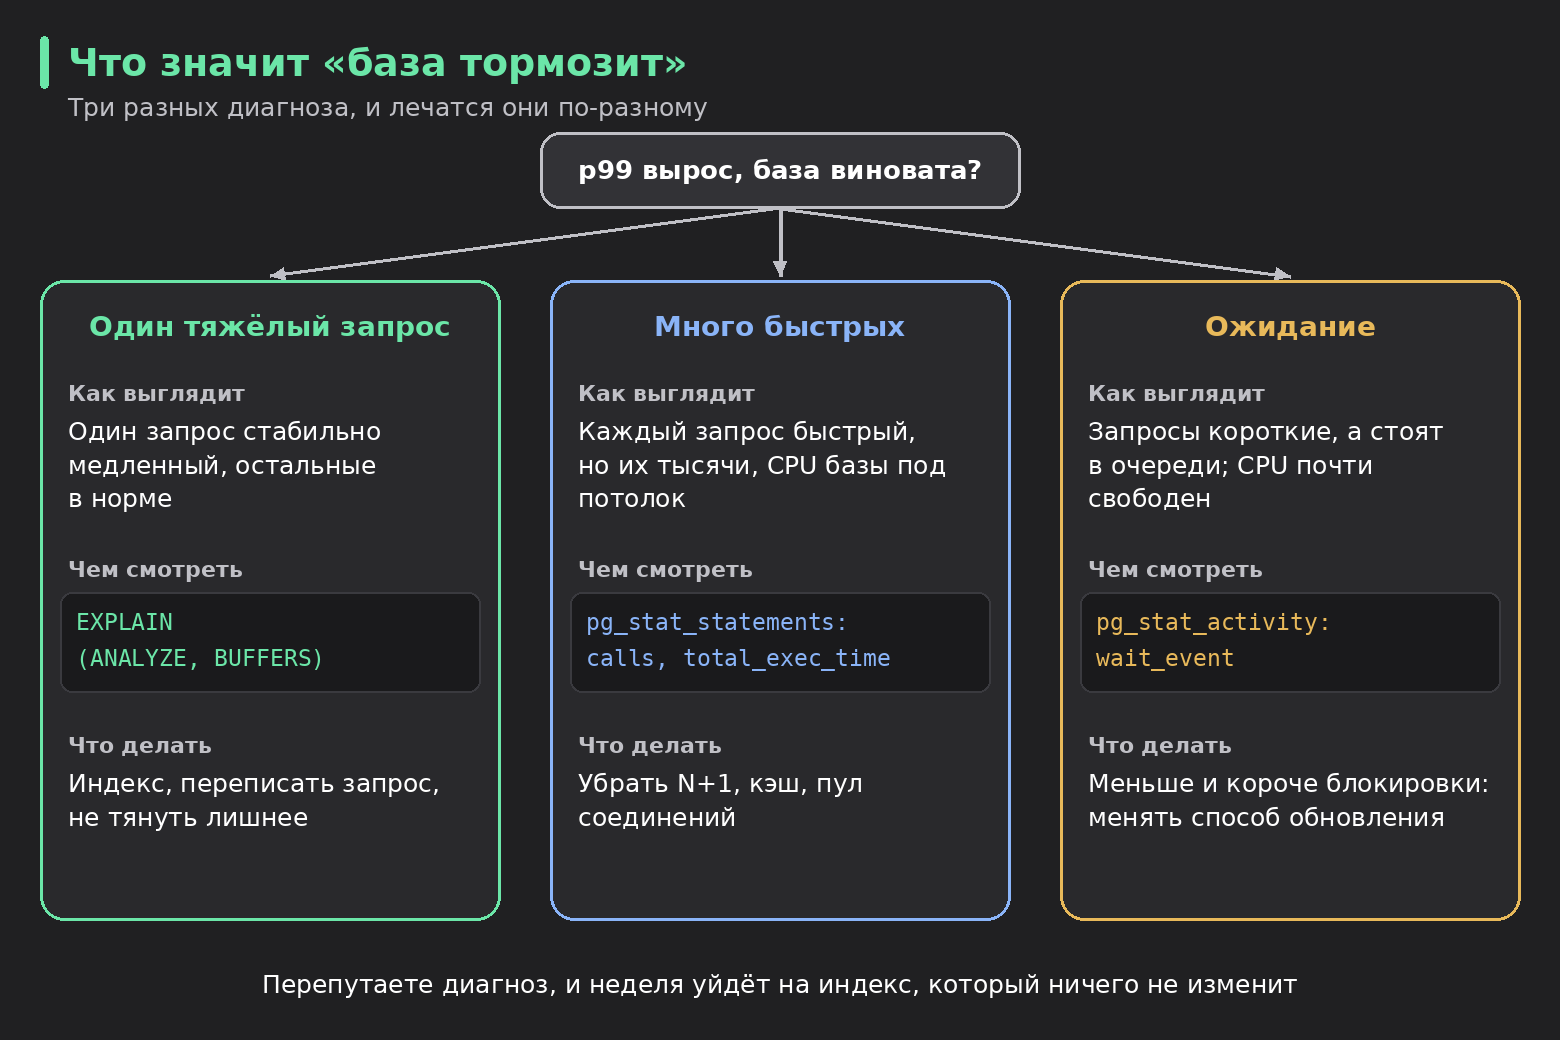
Если спутать диагнозы, неделя уйдёт на индекс, который ничего не изменит. Поэтому первый вопрос такой: сколько длится запрос в приложении и сколько в самой базе. Большая разница значит, что время съели сеть, пул соединений или очередь, и база ни при чём.
Чем смотреть
Для первого диагноза нужен EXPLAIN (ANALYZE, BUFFERS). Я создал таблицу на 2 млн строк с голосами и посмотрел запрос «голоса за карточку за последние 7 дней».
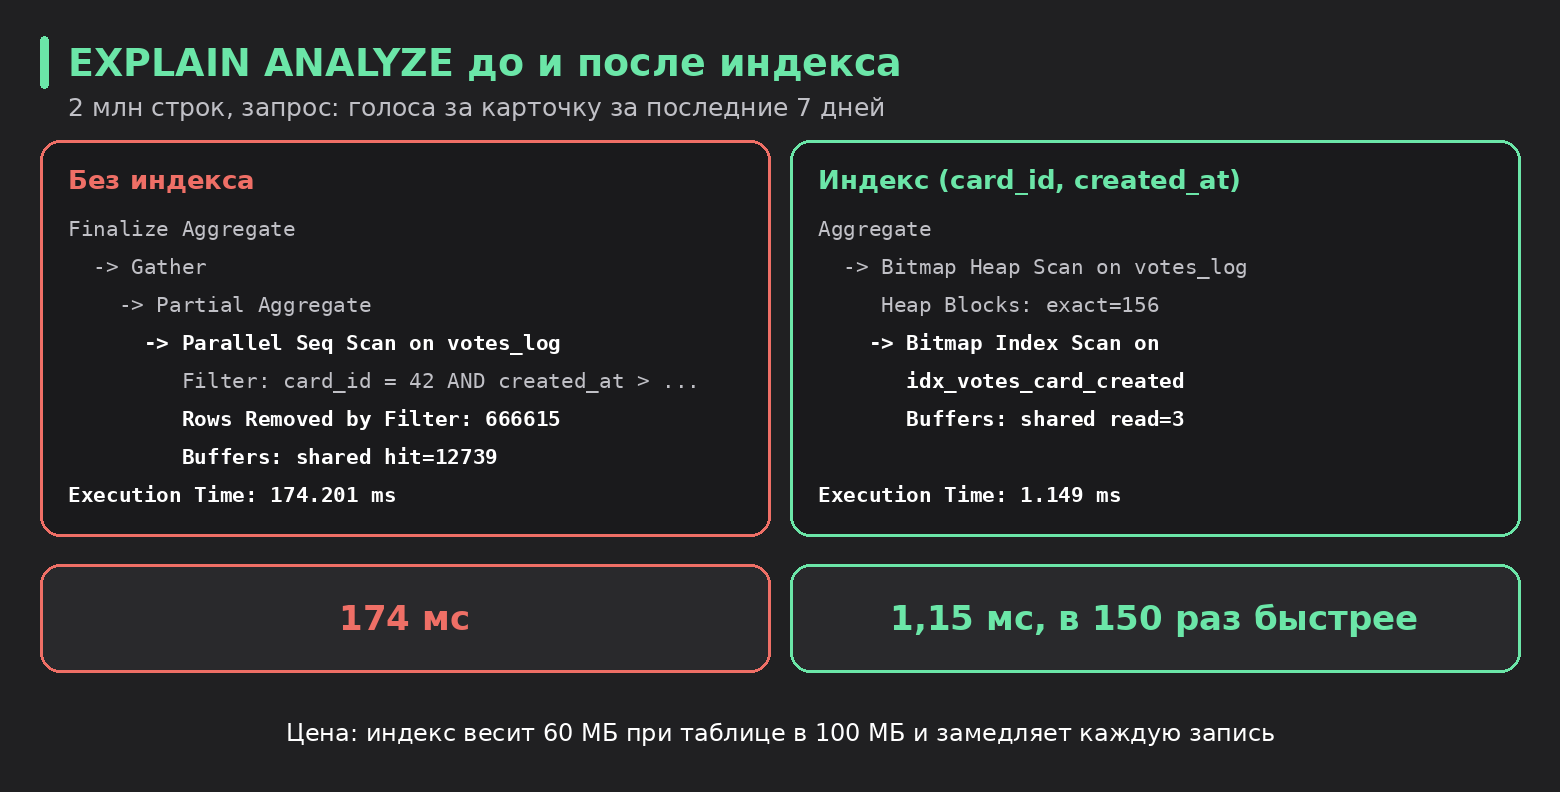
Без индекса Postgres делает Parallel Seq Scan: 174 мс и 12 739 буферов. С индексом 1,15 мс и 159 буферов, то есть в 150 раз быстрее. Цена у этого тоже есть: индекс весит 60 МБ при таблице в 100 МБ, и каждая запись теперь обновляет ещё и его.
Для второго диагноза пригодится расширение pg_stat_statements. Его нужно подключить через shared_preload_libraries, потом:
SELECT calls,
       round(total_exec_time::numeric, 1) AS total_ms,
       round(mean_exec_time::numeric, 2)  AS mean_ms,
       left(query, 60)                    AS query
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 10;
total_exec_time это суммарное время всех вызовов запроса с момента сброса статистики. Верхняя строка этого списка часто оказывается совсем не тем запросом, на который грешили. Для третьего диагноза смотрим, чего именно ждут сессии:
SELECT state, wait_event_type, wait_event, count(*)
FROM pg_stat_activity
WHERE datname = current_database()
GROUP BY 1, 2, 3
ORDER BY 4 DESC;
Если много сессий висит в Lock, то pg_blocking_pids(pid) покажет, кто держит блокировку. С этого места диагноз «ожидание» уже можно ставить.
История про счётчик голосов
На собеседовании в другой компании (названия не будет, важна схема) разговор зашёл про оптимизацию системы, в которой несколько тысяч запросов одновременно голосуют за карточки. Нужен счётчик голосов, который считает правильно. Собеседник рассказал, как сделали у них: значения лежали в базе, доступ к ним шёл через один репозиторий, и в этот репозиторий добавили мьютекс. Все операции записи проходили через него по одной.
Сначала про то, зачем мьютекс вообще понадобился. Наивная реализация выглядит безобидно:
votes = SELECT votes FROM cards WHERE id = 42   -- прочитали, например 100
votes = votes + 1                               -- прибавили в коде
UPDATE cards SET votes = :votes WHERE id = 42   -- записали 101
На одном пользователе всё работает. На тысяче одновременных два запроса могут прочитать 100 и оба записать 101. Один голос потерян, а ошибки нет.
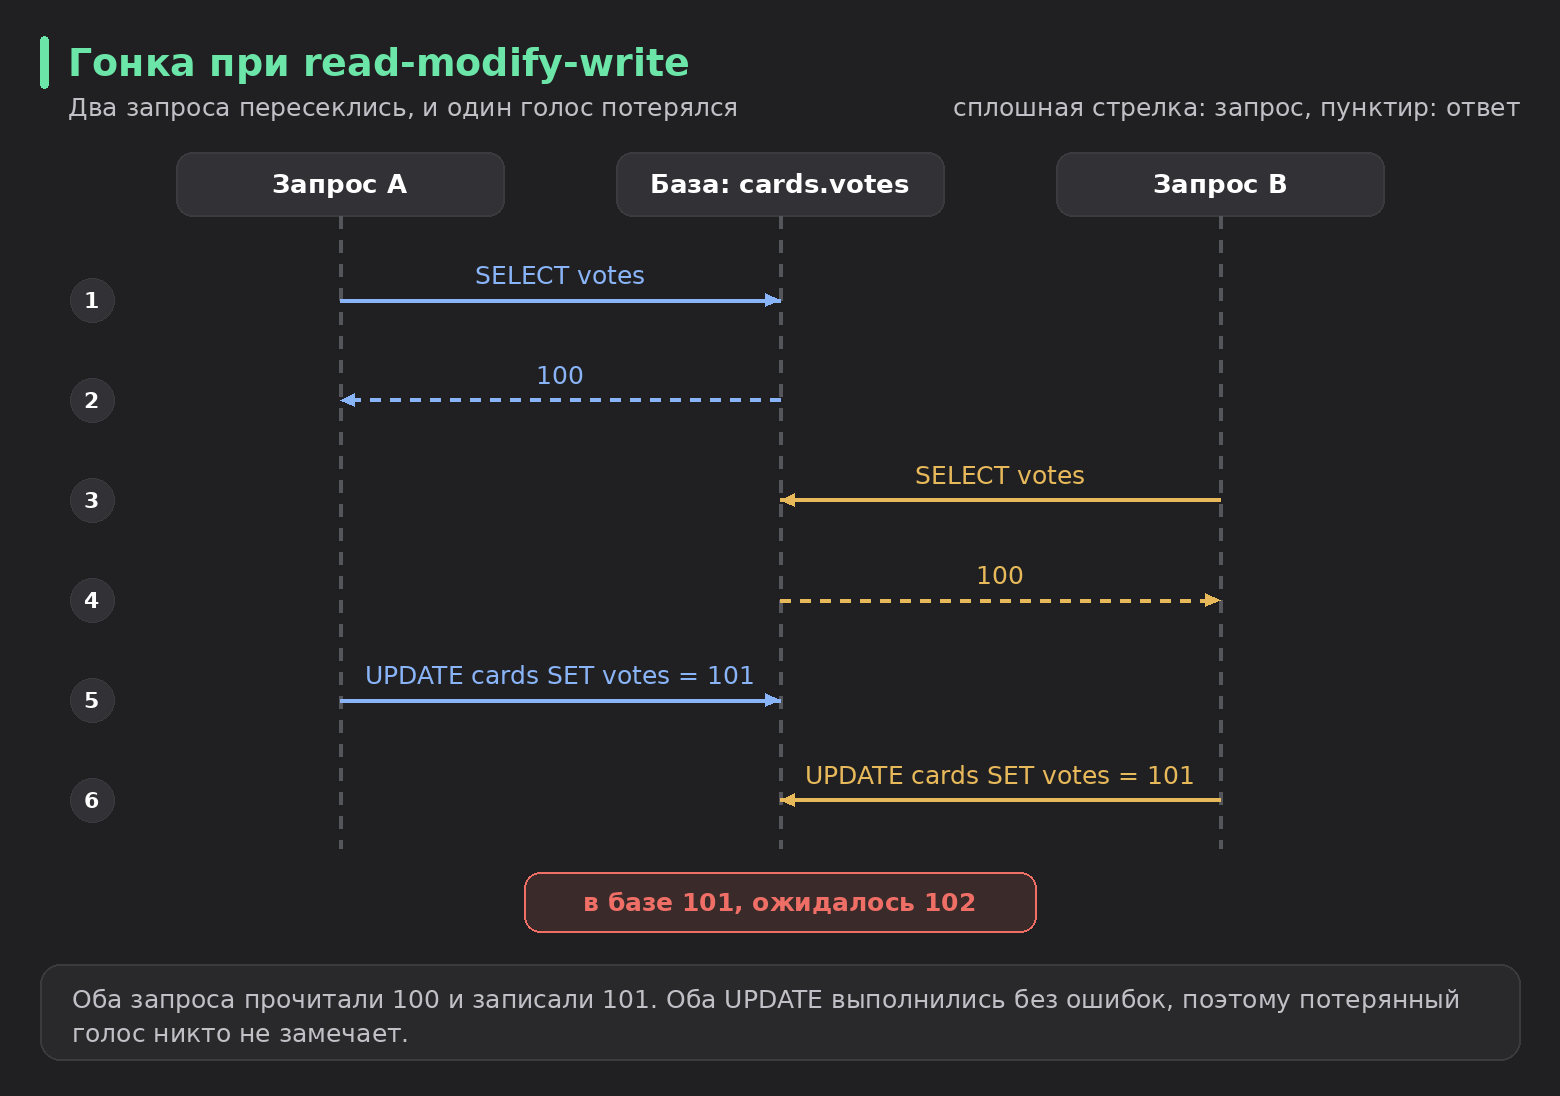
На моём стенде это выглядит жёстко: при 100 параллельных клиентах на одну карточку во всех шести прогонах потеря почти полная: обработано от 4 431 до 8 683 голосов, а в базе осталось от 50 до 96. Это крайний случай, одна горячая строка и сто писателей, но он показывает масштаб.
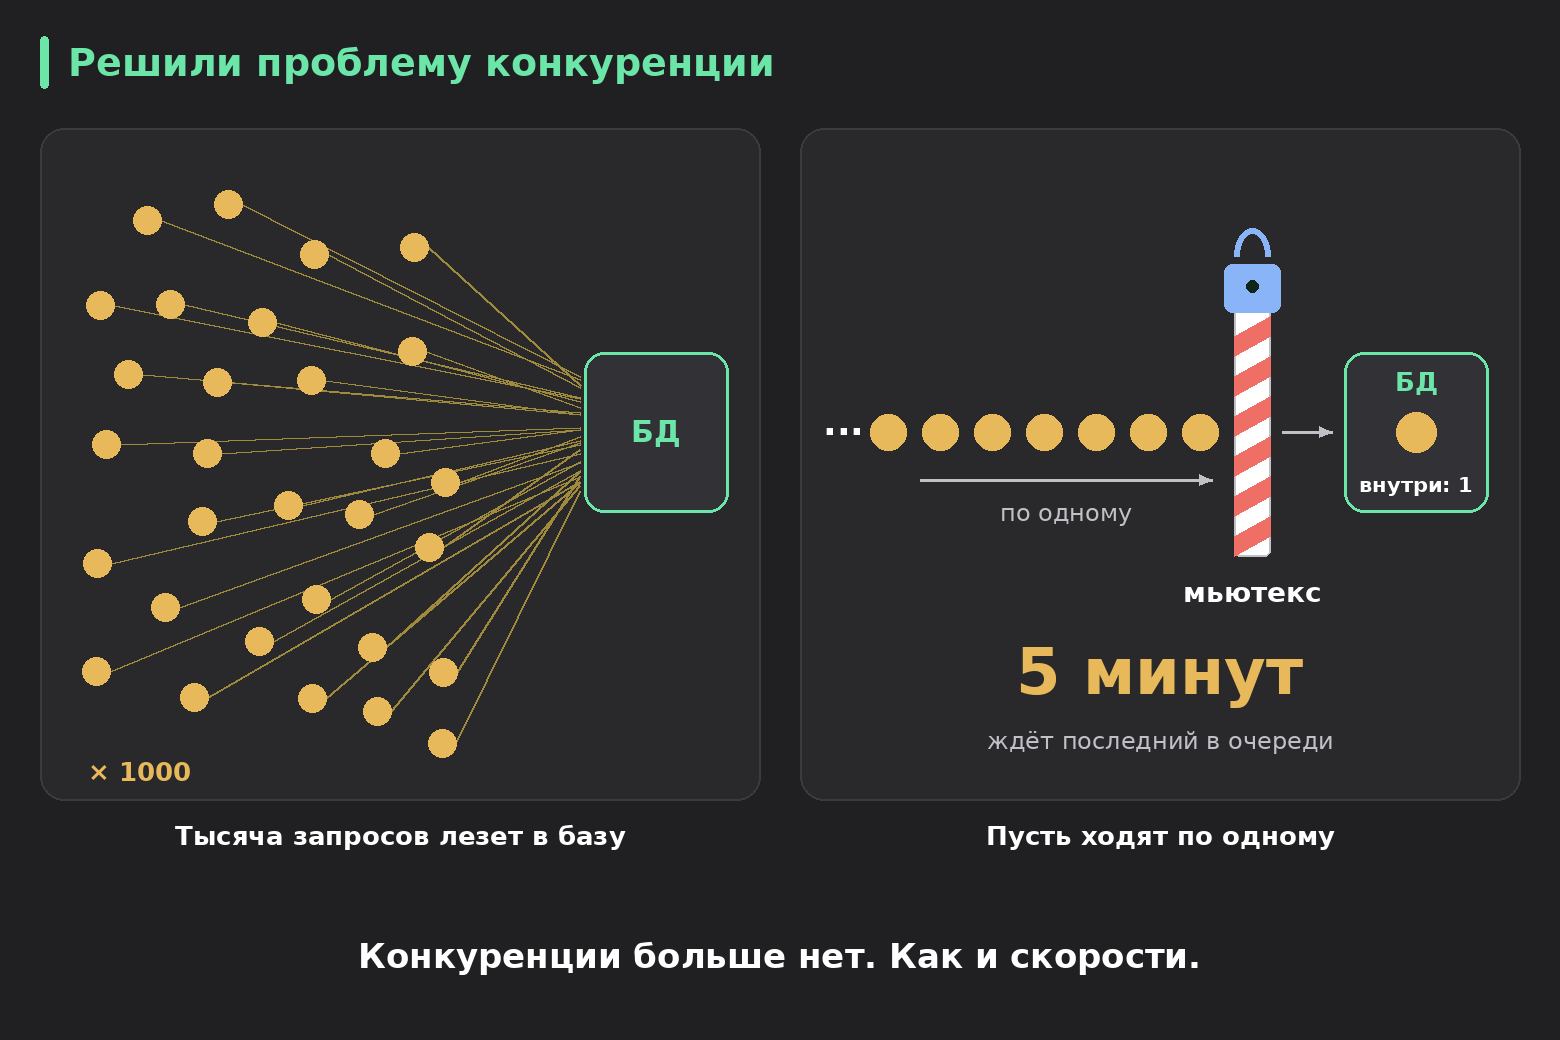
Мьютекс это лечит: записи идут по одной, потерь нет. Дальше возникает вопрос цены, и я её замерил.
Что показал замер
Стенд: PostgreSQL 16.15 в изолированном контейнере без сети (2 CPU, 1 ГБ), pgbench, 100 клиентов, 6 прогонов по 12 секунд на каждый вариант (две серии по три). Мьютекс я эмулировал advisory-локом, который держится на весь цикл «прочитал, прибавил, записал». По смыслу это тот же мьютекс процесса, обёрнутый вокруг похода в базу.
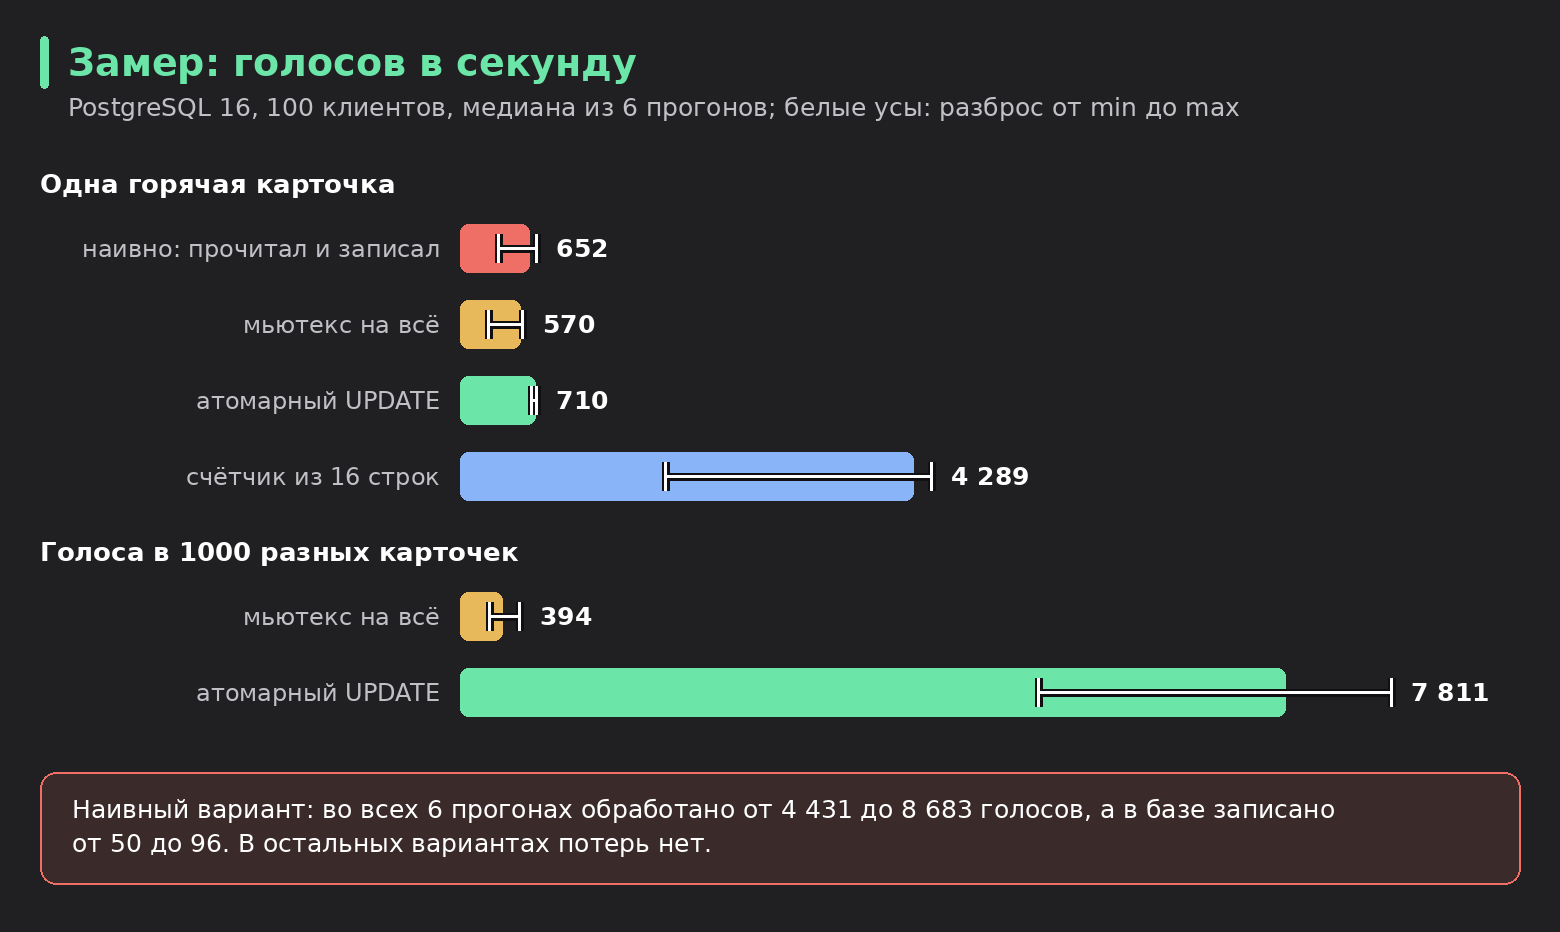
Что видно:
- На одной горячей карточке мьютекс дал 570 голосов в секунду, атомарный
UPDATE710. Выигрыш около 1,25 раза: строка одна, и ждать её приходится в любом случае. - Когда голоса идут в 1000 разных карточек, мьютекс упал до 394, а атомарный
UPDATEвырос до 7 811. Это примерно в 20 раз. Мьютекс общий для всех карточек, поэтому разные карточки ждут друг друга зря. - Шардированный счётчик на горячей карточке дал 4 289, то есть в 6 раз больше атомарного. Про него ниже.
Оговорка. Пока я мерил, на хосте крутилась посторонняя нагрузка (load average от 6 до 28), поэтому абсолютные числа низкие и шумные. Сравнивать нужно отношения, а не сами цифры. Это один хост и шесть коротких прогонов, а не бенчмарк для публикации в журнале. Разброс между прогонами большой (белые усы на рис. 4): в первой серии из трёх прогонов отношения мьютекса к атомарному UPDATE вышли 1,4 (одна карточка) и 14 (тысяча карточек), во второй 1,2 и 23. Поэтому верьте порядку величин, а не второму знаку. Есть и вторая оговорка. Я пробовал сделать мьютекс дешевле: снимать блокировку в том же запросе, что и UPDATE. Счётчик транзакций pgbench в том варианте оказался примерно вдвое больше числа голосов в таблице. Скорее всего, блокировка снималась до коммита, и следующий клиент успевал прочитать старое значение. Причину я отдельно не проверял, а эти прогоны в статью не включил. Если это объяснение верно, урок простой: мьютекс нужно отпускать только после коммита.
Ту же картину показывает pg_stat_activity. Я снял срез на 50 клиентах. При мьютексе 49 сессий из 50 ждали Lock / advisory. При атомарном UPDATE на одной карточке 46 из 50 ждали Lock / transactionid. Очередь есть и там, и там. Разница в том, где она стоит: за мьютексом в приложении все ждут всех, а в базе на блокировке строки ждут только те, кто пишет в одну и ту же карточку.
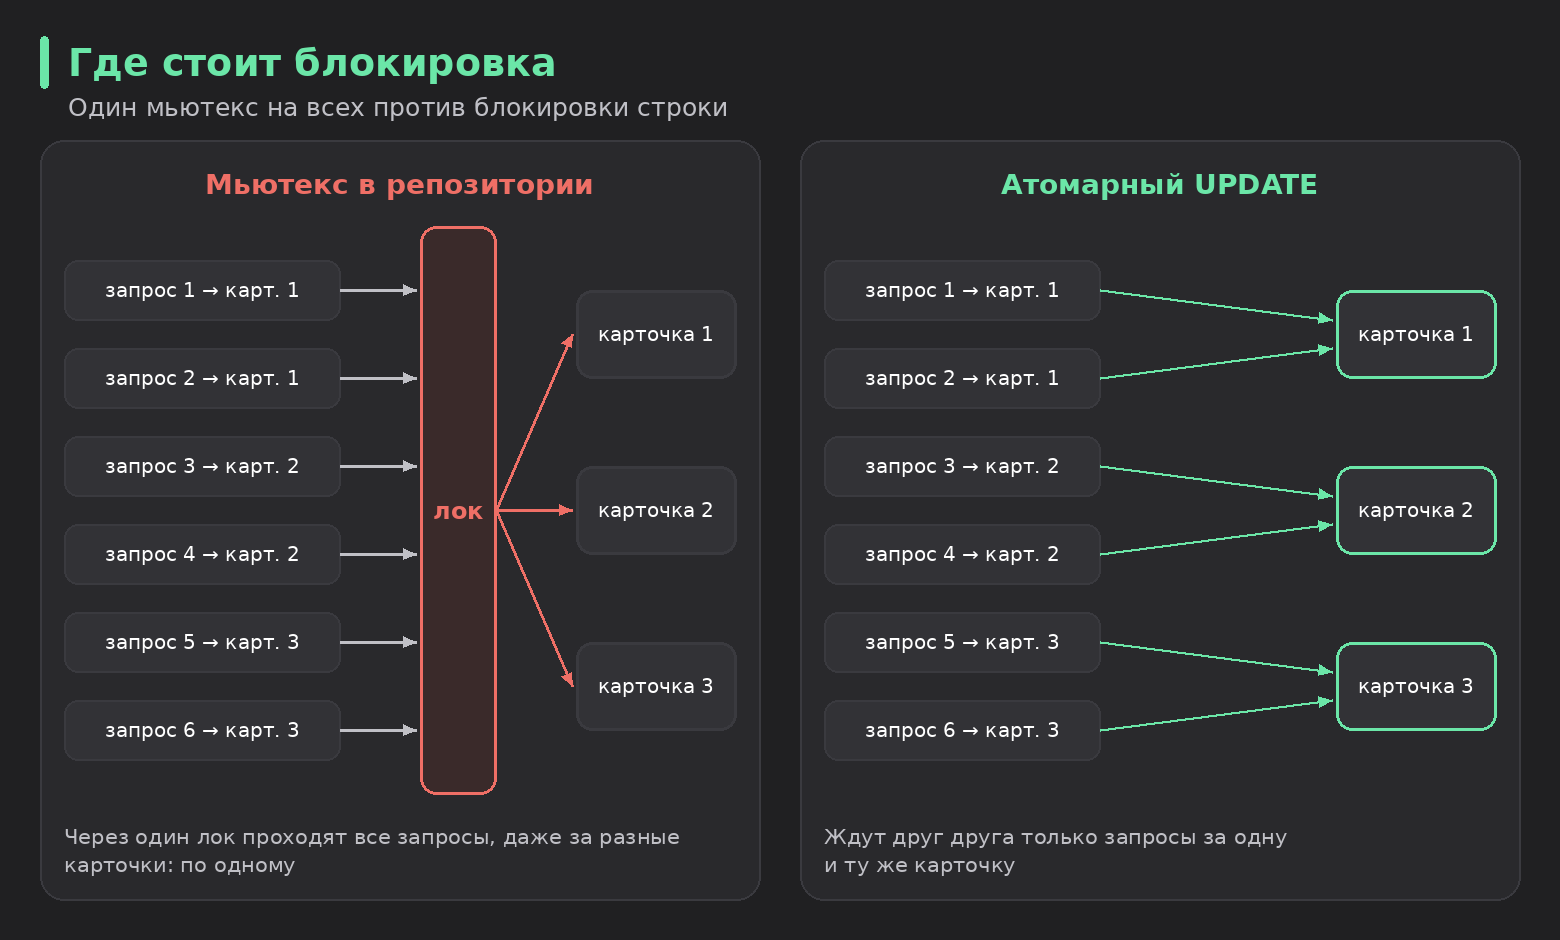
Отдельно, уже без замера, а по устройству: мьютекс живёт внутри одного процесса. Как только вы запустите второй под, у каждого окажется свой мьютекс, и потерянные голоса вернутся. То есть решение ломается ровно тогда, когда вы масштабируете сервис, чтобы справиться с нагрузкой.
Как сделать лучше
Шаг 1. Атомарное обновление в базе.
UPDATE cards SET votes = votes + 1 WHERE id = 42;Чтение и запись происходят одной операцией, гонки нет. Блокируется только строка этой карточки и только до конца транзакции. Работает при любом числе инстансов приложения, мьютекс из кода можно удалять.
Шаг 2. Защита от повторного голоса. Обычно нужно ещё, чтобы пользователь не голосовал дважды. Таблицу голосов делаем с уникальным ключом (card_id, user_id) и увеличиваем счётчик только если голос реально вставился:
WITH ins AS (
  INSERT INTO votes (card_id, user_id) VALUES (42, 7)
  ON CONFLICT DO NOTHING
  RETURNING 1
)
UPDATE cards SET votes = votes + 1
WHERE id = 42 AND EXISTS (SELECT 1 FROM ins);
Я прогнал это на трёх голосах, два из которых были от одного пользователя: счётчик показал 2. Всё в одной короткой транзакции, потому что блокировка строки живёт до её конца, и каждая лишняя операция удлиняет очередь.
Шаг 3. Не считать на чтении. Соблазн показывать COUNT(*) по таблице голосов при каждом открытии карточки. На десятке голосов этого не видно, на миллионе получаете тяжёлый запрос на каждый показ. Держите готовое число в карточке или в кэше.
Шаг 4. Горячая карточка. Если за одну карточку голосуют очень много и одновременно, блокировка строки превращается в очередь. Тут три приёма. Первый я проверил замером: вместо одной строки заводим 16 и пишем в случайную, а при чтении суммируем.
UPDATE card_votes_shards SET votes = votes + 1
WHERE card_id = 42 AND shard = floor(random() * 16)::int;

SELECT sum(votes) FROM card_votes_shards WHERE card_id = 42;
Два других приёма я не замерял, поэтому только описываю. Батчинг: голоса копятся в памяти или в Redis через INCR, а в базу уходят пачкой раз в секунду. Очередь с воркером: запросы кладутся в очередь, один потребитель сворачивает их и пишет в базу. У всех трёх одна цена: число на экране может отставать на секунду-другую. Прежде чем выбирать, честно ответьте себе, нужна ли здесь точность в реальном времени. Для счётчика лайков обычно нет, для остатка товара на складе обычно да.
Лестница масштабирования
Если вернуться от счётчика к базе в целом, я иду по лестнице снизу вверх. Каждая ступень дороже предыдущей, и на каждой есть шанс остановиться.
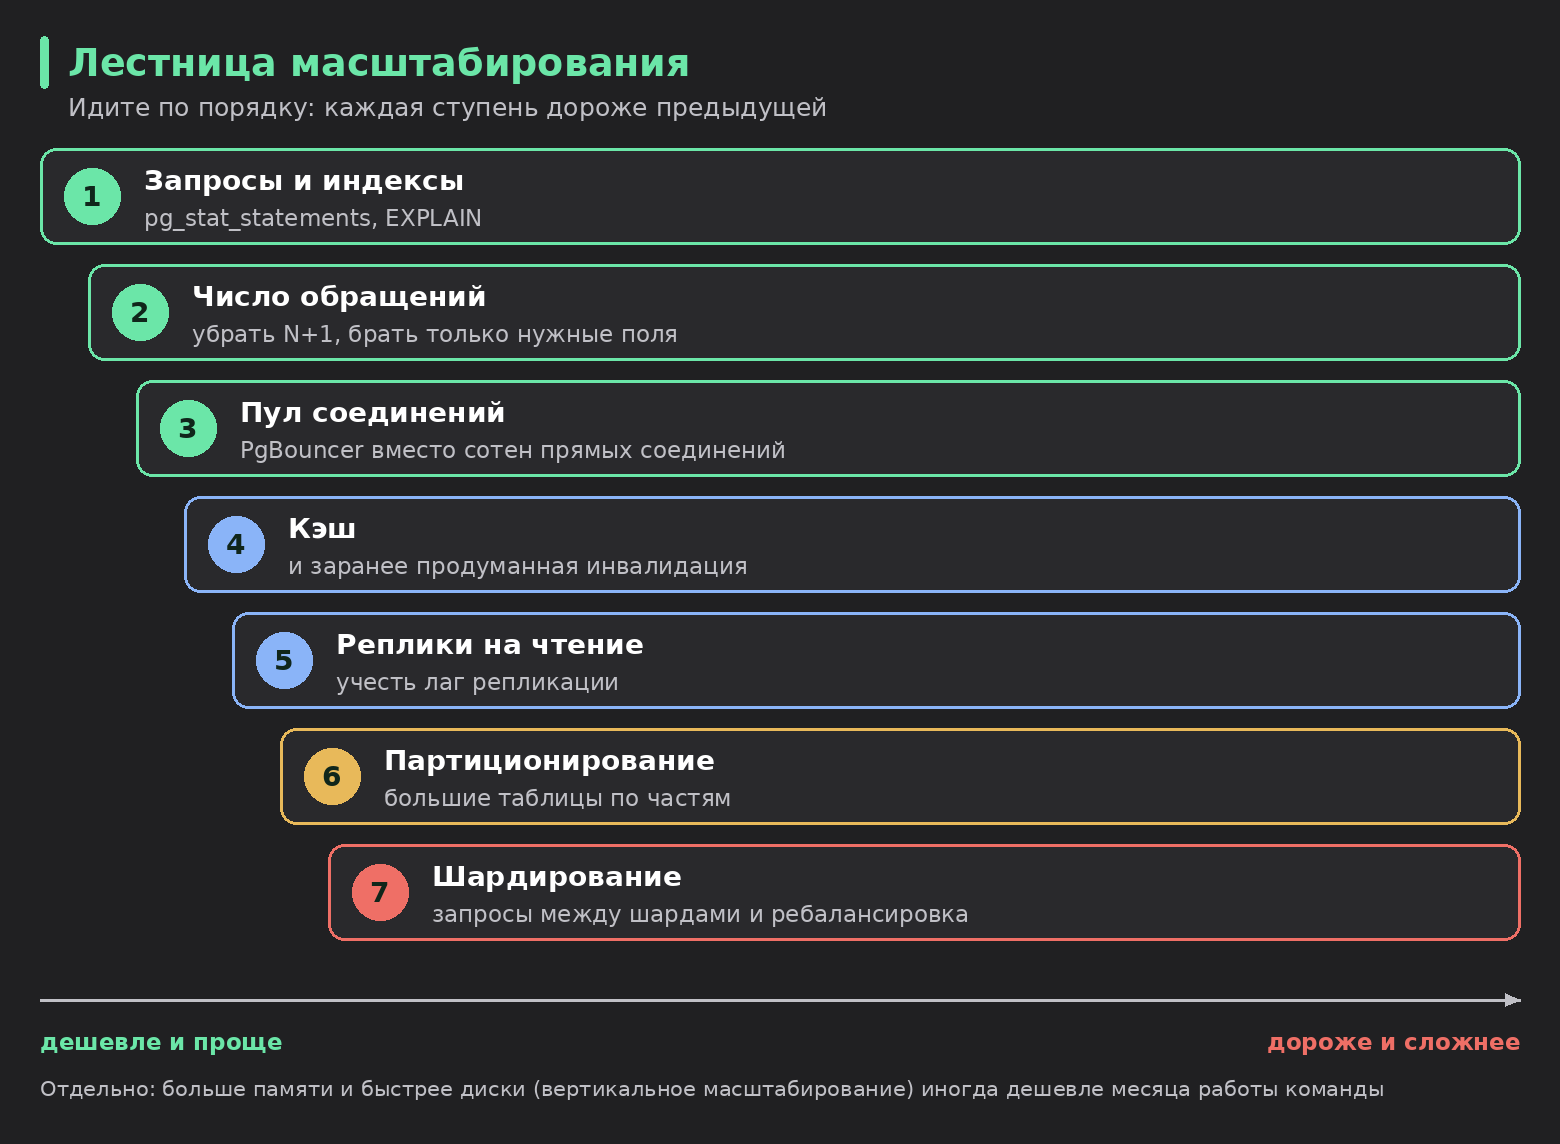
Две ступени требуют пояснения. Реплики на чтение разгружают основную базу, но у репликации есть лаг (его я не замерял, это известное свойство асинхронной репликации): пользователь только что записал данные и не видит их на следующей странице. Шардирование снимает предел одной машины, но приносит запросы между шардами, сложные транзакции и ребалансировку при росте. Дёшево оно не бывает. Отдельно стоит вертикальное масштабирование: больше памяти и быстрее диски иногда обходятся дешевле месяца работы команды над архитектурой.
Чего я бы не делал
- Индекс на каждое поле. На рис. 2 индекс дал выигрыш в 150 раз, но весит 60% размера таблицы. Лишние индексы замедляют запись и занимают память.
SELECT ... FOR UPDATEв длинной транзакции. Блокировка держится до конца транзакции. Если внутри ещё и поход во внешний сервис, очередь растёт на каждый его таймаут.- Кэш без плана инвалидации. Баги от устаревших данных тяжело воспроизводить.
- Шардирование раньше времени. Сначала пройдите ступени ниже.
Короткий чек-лист
- Сравните время запроса в приложении и в базе.
- Посмотрите топ
pg_stat_statementsпоtotal_exec_time. - На подозрительном запросе запустите
EXPLAIN (ANALYZE, BUFFERS). - Если запросы быстрые, а ответ медленный, откройте
pg_stat_activityи посмотритеwait_event. - Конкурентные записи отдавайте базе: атомарный
UPDATE, а не «прочитал и записал» в коде. - Идите по лестнице снизу вверх.
Итоги
«Тормозит» это три разных диагноза, и сначала нужно поставить правильный. Мьютекс вокруг записи в базу решает корректность и платит за это пропускной способностью: на одной карточке разница с атомарным UPDATE небольшая, а на разных карточках в моём замере около 20-кратная. Шардирование стоит в самом конце лестницы.
А как у вас? Встречали мьютексы вокруг базы, и чем это закончилось? Расскажите в комментариях.